 blog
各种红色的多肉-第一百一十四期
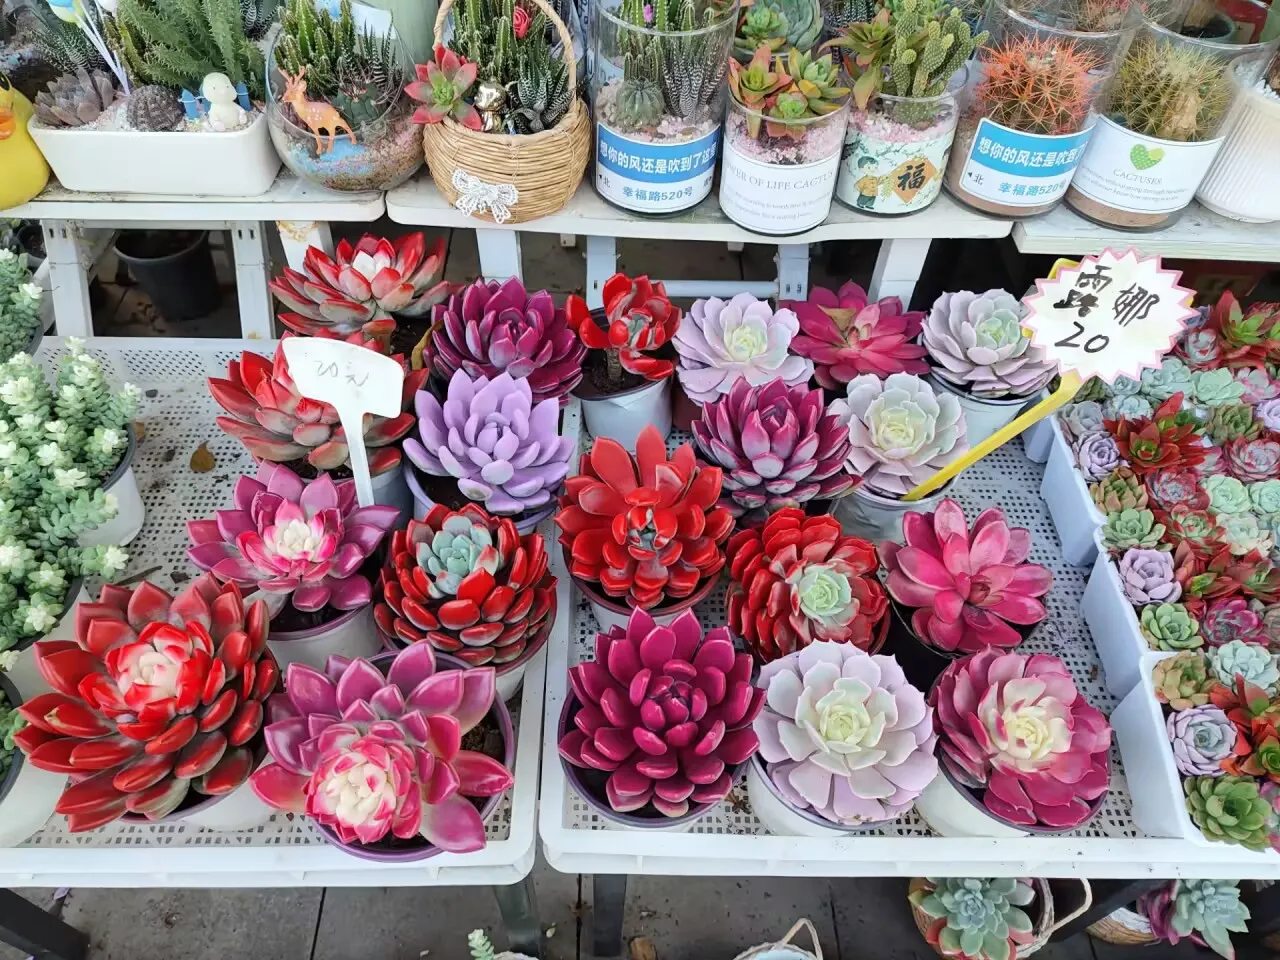
趁着假期去逛了花卉市场,看到各种各样的植物很治愈,而且这个花卉市场还有飞虫走兽,好多小朋友喜欢小鸟呀,大城市里养小鸟,一看就是会飞走,哈哈哈
技术类分享
Transformer 架构的工作原理
https://poloclub.github.io/transformer-explainer/
这是一个交互式可视化工具,用于直观解释 Transformer 架构的工作原理。基于 GPT-2(small,1.24 亿参数)模型,详细展示了文本生成 Transformer 的三大核心组件:Embedding(将文本分词并转为向量表示)、Transformer Block(包含自注意力机制和 MLP 层)、以及输出概率层。用户可以在网页上实时观察 token 如何经过各层处理,是学习 Transformer 原理的优质教育资源。
AI的三种机制
https://w4g1.dev/blog/models-are-getting-dumber-on-purpose
AI 为什么能够回答我们的提问,它怎么会知道答案?
你可以找到很多这方面的论文和书籍,详细解释大模型的运作,通常非常难懂。但是,对于非专业人士,只要简单知道 AI 的三个机制,就可以了。
(1)参数机制
在宏观层面,所有大模型都是对人类知识的建模。它建立了一个数学模型,用来描述所有的人类知识。
怎么描述呢?它使用的是一种参数机制,将知识分解成一个个”词元”(token),然后计算所有词元之间的数学关系。这个过程称为”训练”。
这种数学关系使用无数个参数来表示。举例来说,大模型 GLM 5.3 有7440亿个参数,这些参数用来构建所有词元之间的关系(也就是权重)。所谓”训练”,其实就是找出这个7440亿个权重,描述人类知识的构成,也就是所有词元之间的关联。
一旦训练完成,我们向大模型提问时,它就会根据这些权重,找出最可能的词元,从而生成符合概率的答案。
所以,大模型本质上是一种”压缩-生成”机制,将人类知识抽象在无数参数之中,后期再生成出来。
(2)推理机制
不难理解,参数越多,模型的效果越好。因为更多的参数意味着,可以更精确地描述各种知识,从而可以更准确地将其还原出来。
但是,一方面,参数不可能无限增加,训练和使用成本将直线上升,使用时的运算时间也会变长。
另一方面,也没有必要包含所有的知识,很多知识不需要包含在参数之中,完全可以通过逻辑推理获得。
举例来说,只需要知道某个城市的人口出生率和死亡率,就马上知道了人口的净增长率。这不需要记忆,可以通过推理得到。
大模型就依靠推理机制,根据参数包含的知识,从逻辑规则出发,推断出那些它没有包含的知识。
(3)联网机制
不管模型有再多的参数、再强的推理,它不可能包含所有的知识,总有一些问题它回答不了。
比如,你问大模型,今天股票的收盘指数是多少,它就回答不了。参数里面不包含这个知识,也无法推理得到。
这时,模型就要依靠 Agent 或应用框架提供的联网机制,自动去互联网搜索那些它不知道的知识。
(4)总结
正是有了以上三种机制,AI 才能正确回答我们的问题。
首先,参数机制提供了大模型的基本知识;其次,推理机制产生通过推理得到的知识;最后,联网机制用来获取前两种机制都无法得到的知识。
动荡的人工智能时代已经到来
比尔盖茨本周发表了一篇文章,提出 AI 有风险,应该减缓发展速度。
但是,他在20023年发表过一篇完全相反的文章《AI 的风险是可控的》。
到底为什么,三年的时间,改变了他的观点。不过,不管他怎么想,AI 的发展只可能加速,不可能慢下来。
非技术类分享
AI挤占了一切空间
https://news.ycombinator.com/item?id=49340340
当前 AI 热潮的一大问题是,它挤占了所有其他讨论的空间。
大家以前都在讨论编程语言、协议、算法、架构…现在这些话题都去哪儿了?我们甚至都不确定它们是否还有意义。
事实上,大家可能在心里怀疑它们已经不是那么有用了,所以才懒得去讨论。
AI 似乎把所有其他成就的价值都贬低了。如果我在工作中有什么想法,这些想法现在都会因为 AI 而得不到应有的认可。
即使你的想法可能真的不错,但我们已经被 AI 生成的想法淹没了。每次你向 AI 提问,它都会告诉你几十个可以改进的地方。谁又能说哪个才真正重要呢?这些想法真的还有意义吗?为什么别人要在意那些轻而易举就能得到的东西呢?
公开演讲的窍门
https://blog.guillheu.dev/articles/first-time-speaker/
(1)成功的演讲,内容只占30%,表演技巧占70%。
你要知道,演讲是一场秀,你要充分利用语气、动作、表情、手势等等,去吸引听众的注意力,内容其实不是决定性的。
(2)提前做好充分准备。
演讲稿、幻灯片、笑话、语调、节奏,所有细节最好都反复练习过。你无法预知上台时会发生什么,反复练习能让你沿着预设的轨道,顺利进行下去。
(3)如果涉及具体技术细节,你最好多讲”为什么”(why),让听众明白为什么应该关注这些。
至于”如何做”,略微讲一讲大致思路和一般概念即可,具体操作和实现可以全部跳过,因为没人想听你背诵文档。
(4)紧张是正常的。
但是,如果你做了充分准备,把稿子背得滚瓜烂熟,上台后一旦进入状态,你很快就会把紧张忘记。
(5)不管讲得好与坏,你一定要自信。如果你自己都对所讲的内容有迟疑,就很难让听众信服。
公开演讲的成功者,都是自信的人,而不是能力强的人。很多槽糕的管理者和骗子,都发表过成功的演讲,这说明内容绝非登上讲台的必要条件。
(6)只要你渴望谈论某个话题,你就绝对有登上讲台的条件。
奇怪的谷歌搜索
https://sancho.bearblog.dev/google-weird/
搜索的本质是找到历史相关的记录,确实不需要ai进行总结或者分析,然后还将ai的分析放于最上方,这个设计有点不如人意,希望Google很快能进行修正。